NVIDIA Minerva se presenta como una plataforma de operaciones asistidas por inteligencia artificial para correlacionar telemetría de fábricas de IA. NVIDIA señala que estos entornos combinan GPU, redes, almacenamiento, planificadores y procesos de entrenamiento distribuidos, y que un componente degradado puede ralentizar un trabajo aunque otros recursos sigan funcionando con normalidad.
Según la compañía, algunos problemas no superan los umbrales fijos de alerta y solo se aprecian al comparar componentes o relacionar señales de distintas capas. La información suele estar repartida entre equipos de redes, computación y aprendizaje automático, lo que puede dificultar la identificación de los trabajos y recursos afectados.
Telemetría y topología en un mismo análisis
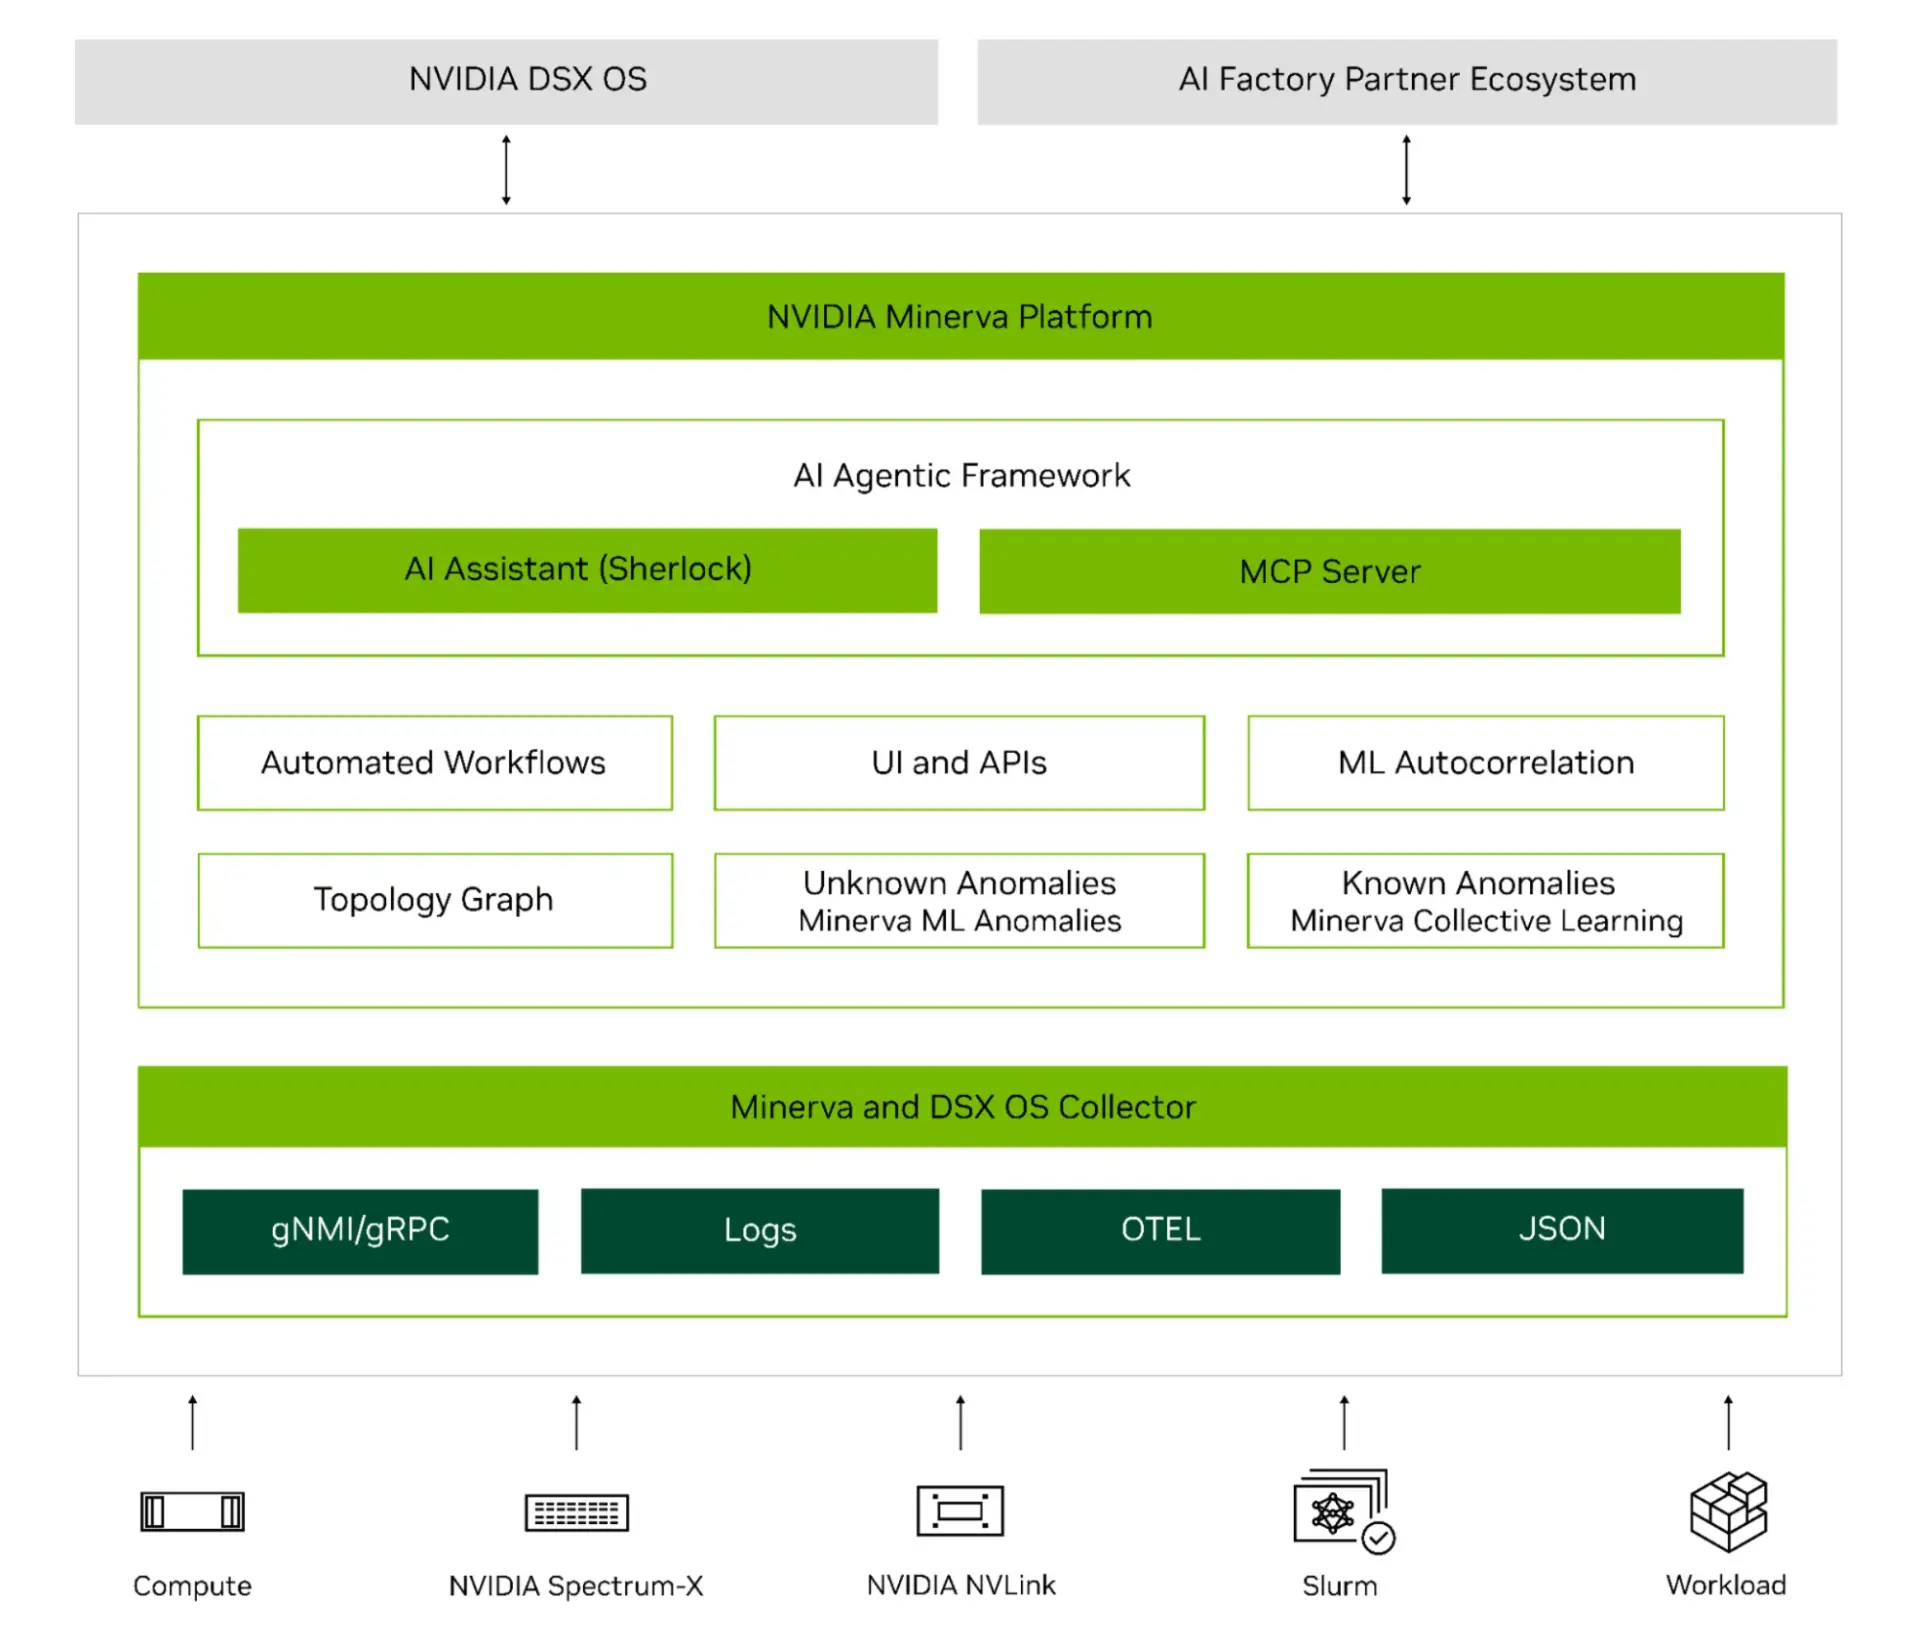
Minerva recopila métricas, registros y datos de topología de GPU, conmutadores, redes, almacenamiento, planificadores y cargas de trabajo. La plataforma crea un grafo de conocimiento que relaciona la infraestructura con los trabajos activos y actualiza esas conexiones cuando cambia el entorno. NVIDIA indica que la vista puede abarcar varios centros de datos y llegar desde el conjunto de la instalación hasta una interfaz concreta.
La compañía explica que esa relación permite investigar desde un trabajo afectado hacia sus GPU, servidores y rutas de red, o partir de un evento de infraestructura para localizar las cargas de trabajo vinculadas. La plataforma también emplea modelos supervisados y no supervisados para detectar patrones conocidos y desviaciones respecto del comportamiento de componentes comparables.
Figura 1. Plataforma de observabilidad AIOps de NVIDIA Minerva.
De las alertas a los incidentes
La correlación basada en la topología agrupa, según NVIDIA, eventos que comparten una ruta de dependencia. Así, señales relacionadas pueden presentarse como un incidente con información sobre la topología y las cargas afectadas. La empresa afirma que sus pruebas muestran reducciones de eventos notificados y tickets en escenarios compatibles; los operadores aún deben determinar la causa raíz con las herramientas de la plataforma.
Minerva incluye Sherlock, un agente de IA que consulta telemetría activa y el grafo de conocimiento. NVIDIA señala que puede mostrar evidencias y recomendar medidas de solución. Un servidor MCP permite que herramientas externas consulten el mismo contexto operativo; la mitigación puede requerir aprobación humana o automatizar determinadas acciones conforme a las políticas locales y al riesgo.

Figura 2. Grafo de topología de NVIDIA Minerva.
Casos de uso descritos por NVIDIA
En un ejemplo de una fábrica de IA con unas 400.000 interfaces, la compañía relata que Minerva detectó una conexión NVLink que perdía ancho de banda y la relacionó con los trabajos que cruzaban por ella. El equipo aisló el enlace y drenó y reprogramó los nodos afectados. NVIDIA afirma que el diagnóstico se completó en minutos, en lugar de horas.
Otro caso descrito por NVIDIA parte de un error poco frecuente en la ruta de una SuperNIC. La plataforma lo identificó en los registros y envió una alerta con contexto y pasos de solución; el ingeniero de guardia confirmó el fallo y retiró el nodo del conjunto de asignación antes de que recibiera una carga de cliente. En un caso distinto, un problema de alimentación de un dispositivo NVMe ralentizó trabajos en un nodo; la empresa estima que la solución ahorró 5.530 horas de ejecución.

Figura 3. Mantenimiento proactivo de SuperNIC.
Resultados y desarrollo
NVIDIA también describe un incidente en el que un problema de conmutador generó hasta 81 eventos y anomalías. La correlación de Minerva los vinculó con un trabajo afectado y los presentó como un único incidente. Según la compañía, gestionarlo de ese modo redujo el tiempo de reparación y ahorró alrededor de 54 horas de disponibilidad total del clúster.
La empresa atribuye a sus pruebas internas un aumento del tiempo medio entre interrupciones y una reducción del tiempo medio de reparación y del ruido de alertas. También indica que Minerva se está desarrollando en coordinación con NVIDIA DSX OS y que prevé integrar componentes seleccionados de salud y resiliencia; las capacidades de Minerva empezando por el recolector de datos pasarán a formar parte del código abierto de DSX OS.
La publicación presenta la plataforma como una forma de reunir información de GPU, redes, almacenamiento y cargas de trabajo, y de facilitar la investigación de degradaciones. Para la documentación técnica y las guías de despliegue, NVIDIA remite a https://networking-docs.nvidia.com/minerva/1.0.1. También ofrece información sobre la integración con DSX OS en https://docs.nvidia.com/dsx#dsx-os.