NVIDIA Mission Control 2.5 amplía su motor de recuperación autónoma a las cargas de trabajo basadas en Kubernetes gestionadas con NVIDIA Run:ai. Hasta ahora, el servicio estaba limitado a cargas de computación de alto rendimiento que utilizaban Slurm.
La actualización busca ayudar a operar fábricas de inteligencia artificial con trabajos distribuidos en cientos de nodos durante días o semanas. En esos entornos, las anomalías de hardware, los errores de software, los problemas de red y la competencia por recursos requieren una gestión proactiva, según explica NVIDIA.
El motor puede detectar, diagnosticar y responder a anomalías en distintos niveles. La compañía presenta la ampliación como un paso hacia una infraestructura capaz de recuperarse de forma autónoma y reducir las interrupciones de las cargas de trabajo.
Recuperación integrada para Kubernetes
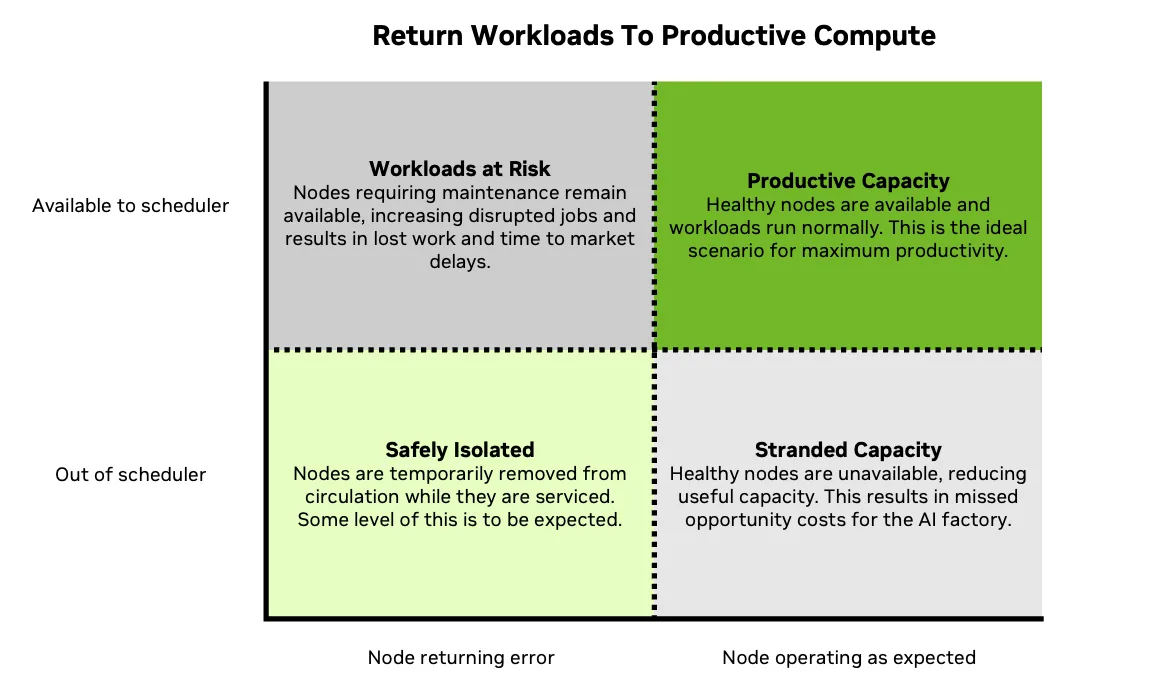
El sistema combina dos servicios: recuperación autónoma de trabajos y recuperación autónoma de hardware. Ambos trabajan junto con el planificador de cargas de trabajo para identificar fallos, aislar anomalías y devolver los recursos a un estado productivo.
La recuperación de trabajos analiza el contexto de cada tarea y su historial de fallos para orientar acciones como reiniciar, reintentar, volver a poner en cola o cambiar su ubicación. El servicio de hardware supervisa nodos y GPU, puede retirarlos de la planificación y ejecuta diagnósticos o medidas correctivas.
En Kubernetes, NVIDIA Run:ai actúa como planificador predeterminado de Mission Control y gestiona las cargas de trabajo, las colas y las políticas. La separación de funciones permite que el servicio de trabajos se centre en las cargas y que el de hardware gestione el estado de la infraestructura.
Respuesta ante distintos fallos
Si una GPU falla durante el entrenamiento, el servicio de recuperación de trabajos captura el contexto y el sistema puede reiniciar o reubicar la carga en GPU sanas. En paralelo, el servicio de hardware aísla el nodo afectado, registra el motivo e inicia diagnósticos.

Ante un fallo de software que pueda ser transitorio, el servicio puede optar por reintentar la tarea conforme a las políticas del planificador, sin aislar hardware si no hay indicios que lo justifiquen. Si los fallos se repiten o no permiten reintentar, el proceso puede escalar el problema.

Detección temprana y operación
El servicio de hardware también puede detectar señales de degradación antes de que provoquen un fallo en un trabajo. En ese caso, puede retirar el nodo de la planificación y comenzar los diagnósticos antes de que se le asigne una carga de entrenamiento.

NVIDIA señala que Mission Control 2.5 ofrece un modelo de recuperación común para entornos Kubernetes y Slurm. Los trabajos pueden reiniciarse, reintentarse o volver a la cola según el planificador utilizado, mientras el motor aporta contexto para evitar repetir fallos en infraestructura que requiere atención.
La compañía indica que el objetivo es aprovechar mejor la capacidad de aceleración y mantener las cargas de entrenamiento productivas. El comportamiento descrito depende del tipo de fallo y de las políticas del planificador.
Disponibilidad y otras novedades
NVIDIA Mission Control 2.5 está disponible. Los usuarios actuales pueden consultar la documentación del producto para obtener información sobre la actualización.
Entre las novedades de la versión, NVIDIA menciona un servicio de detección de anomalías de red asistido por IA, disponible solo en beta; mejoras en la experiencia de autenticación mediante Keycloak centralizado; actualizaciones de seguridad y refuerzo de Kubernetes, y acceso anticipado a NVIDIA Vera Rubin NVL72.
La empresa ha publicado las notas completas de la versión y una descripción general de la solución.