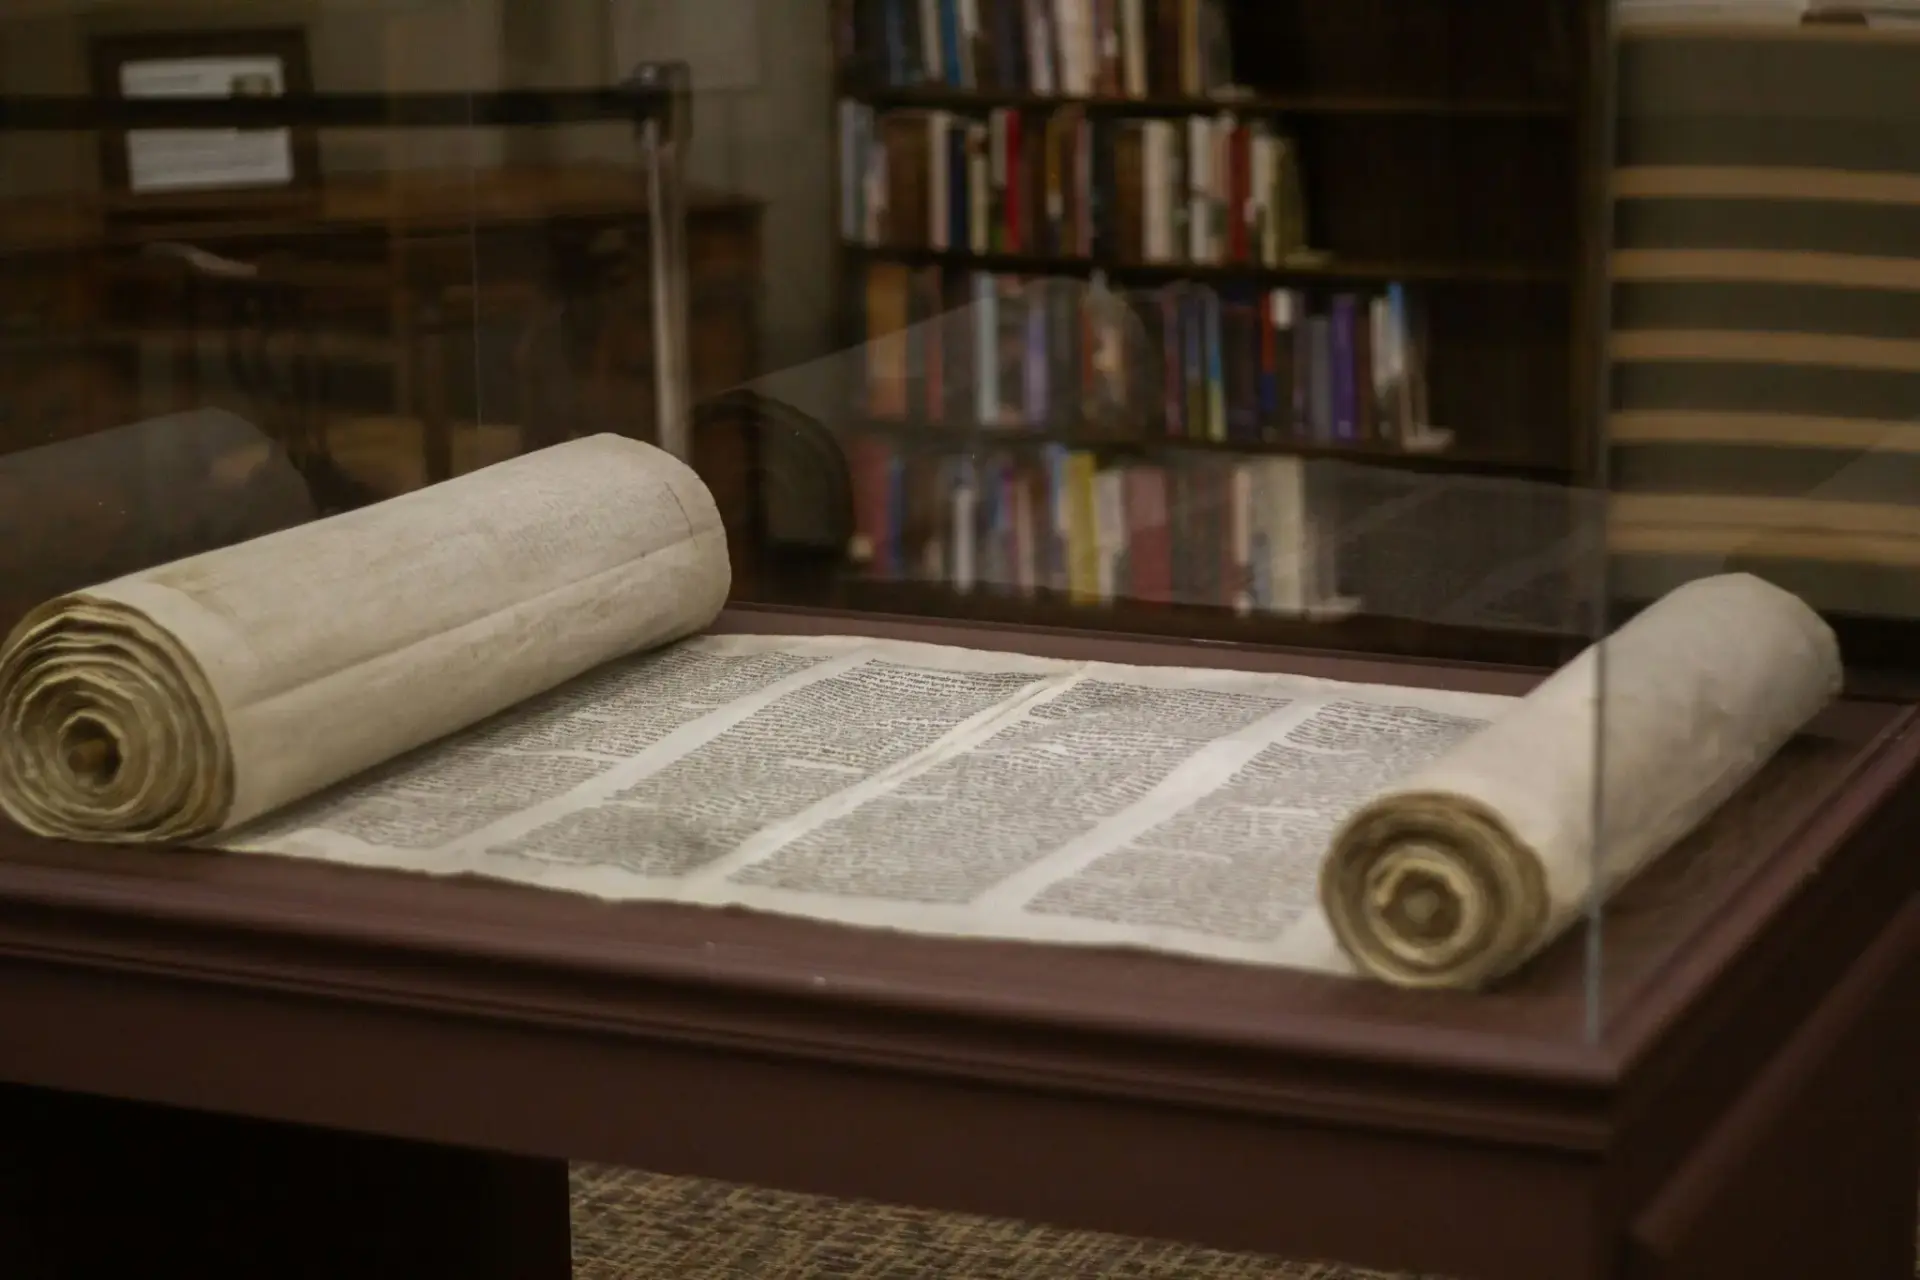
Los papiros de Herculano, carbonizados por el Vesubio, tienen desde ahora un lector capaz de adivinar lo que el fuego borró. El sistema se llama Apollo y lo ha desarrollado la Academia Austriaca de Ciencias junto a la empresa Sail Reply y el laboratorio Mistral.
La cifra que lo explica todo son 600 millones de palabras. Ese es el corpus con el que se ha entrenado: inscripciones en piedra, manuscritos y papiros de hace más de dos mil años. Con esa base, el modelo no se limita a reconocer letras sueltas. Predice qué palabra encaja en un hueco y descarta las que no encajan por época, por dialecto o por fórmula documental.
Hasta ahora, leer un fragmento dañado dependía de un puñado de especialistas capaces de reconstruir de memoria fórmulas notariales, giros de la koiné y abreviaturas de escriba. —Hay muy pocas personas en el mundo que sean tan buenas en historia griega—, recordó Stephen Colvin, profesor del University College London. La herramienta no sustituye ese saber: lo reparte.
La aplicación práctica es un chatbot de acceso libre para la comunidad universitaria. Un filólogo puede plantear una secuencia incompleta y recibir varios candidatos ordenados por probabilidad, con el contexto que los sostiene. También puede rastrear colecciones enteras en busca de nombres, fórmulas de datación o giros administrativos, una tarea que antes consumía meses de revisión manual.
Es el primer modelo de lenguaje avanzado dedicado al mundo clásico, según sus desarrolladores, y la diferencia con un corrector ortográfico corriente está en el registro.
Donde antes había una laguna de cuatro letras hay ahora tres palabras posibles y un orden de probabilidad que el historiador puede discutir.
Cómo se rellena un hueco que lleva dos mil años vacío
El detalle que separa a Apollo de un corrector cualquiera es la sensibilidad al registro. —Cuando ve a Homero, completa el griego homérico; cuando ve una inscripción en dialecto dórico, utiliza el dialecto dórico—, explicó Anna Dolganov, historiadora de la Academia Austriaca de Ciencias. El modelo distingue la épica de un contrato de matrimonio y ajusta su vocabulario en consecuencia.
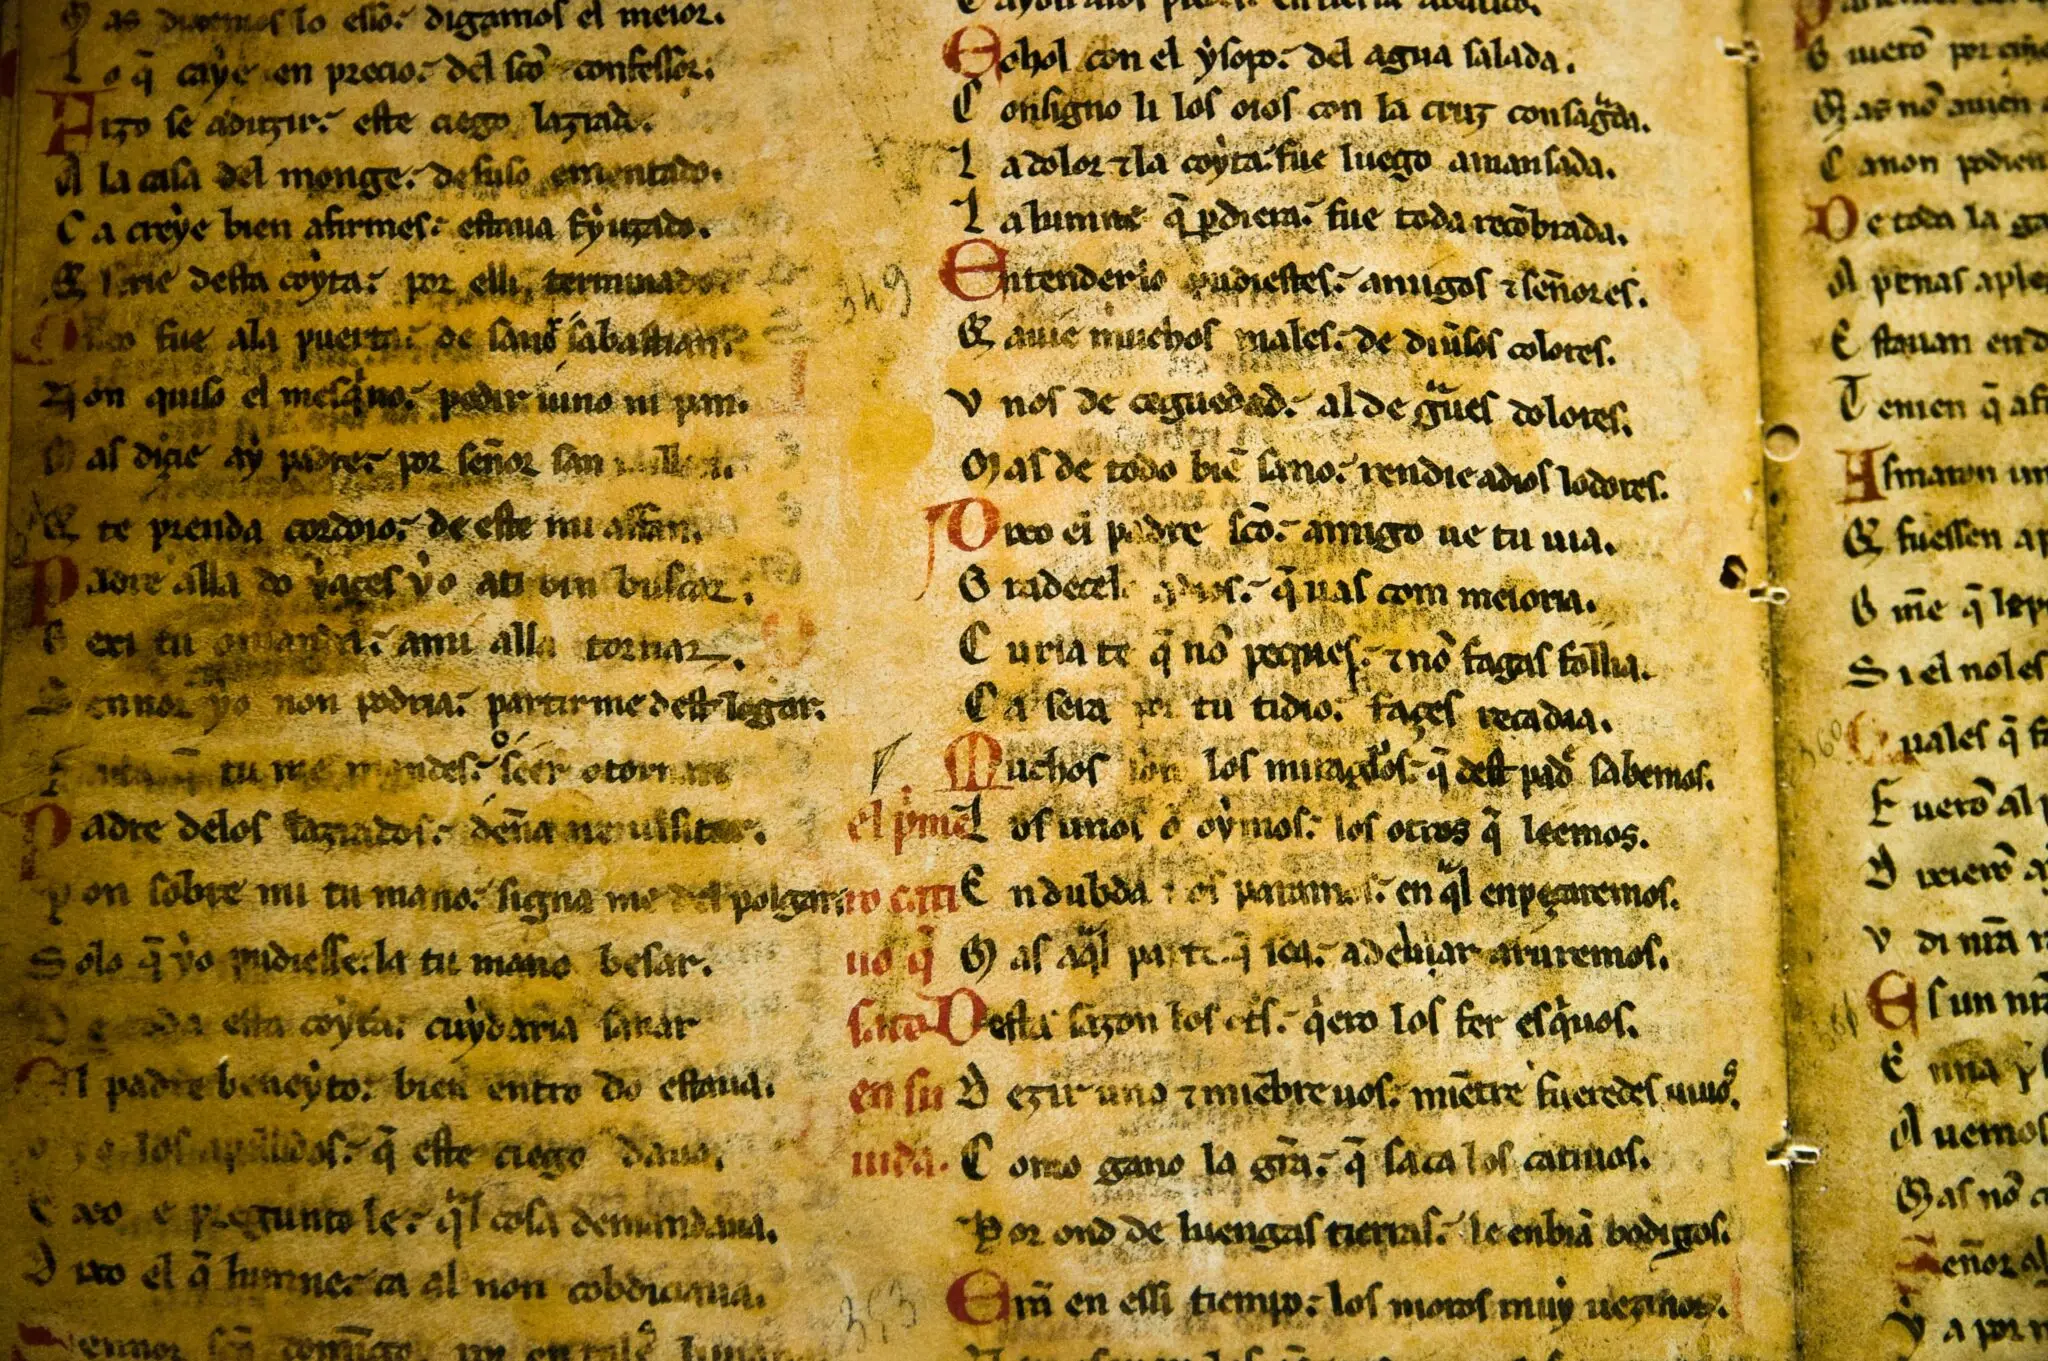
Para dimensionar el entrenamiento: 600 millones de palabras equivalen a unos 6.000 libros de cien mil palabras cada uno. A un volumen por semana, leerlos llevaría más de 115 años sin un solo descanso. La máquina los ha recorrido en la fase de entrenamiento, antes de enfrentarse a un solo papiro incompleto.
El contexto ayuda a medir el alcance. Los rollos de Herculano llevan años siendo fotografiados con técnicas de imagen que permiten leer capas internas sin desenrollarlos, con resultados desiguales según el estado del material. Apollo ataca un problema distinto y complementario: no la imagen, sino la lengua. Si el texto legible cubre una parte del rollo y el resto son lagunas, el modelo propone qué pudo haber en ellas.
Lo que se espera encontrar tampoco son obras maestras perdidas. Los documentos conservados son, en su mayoría, contratos matrimoniales, cartas privadas, y certificados administrativos. Cada fragmento descifrado, según los filólogos que presentaron el proyecto, añade un elemento diminuto de conocimiento sobre el mundo antiguo. Sumados, esos elementos diminutos componen la vida cotidiana de una civilización que solíamos mirar solo por el ojo de sus élites.
Quién decide qué palabra falta
Aquí está la parte que más me interesa y también la más delicada. El sistema no devuelve una transcripción cerrada: muestra opciones probabilísticas y deja la elección al historiador. —El punto crucial es que la competencia humana debe permanecer; si dependemos totalmente de las transcripciones de la máquina, es cuando empiezan los problemas—, advirtió Dolganov. La cautela no es retórica. Un modelo de lenguaje entrenado para completar texto tiende a elegir la palabra más probable, no necesariamente la correcta, y en un papiro único no hay segunda copia contra la que contrastar.
Sobre la solidez del anuncio conviene ser claro: la información difundida no incluye métricas públicas de acierto ni una evaluación independiente del modelo, y tampoco detalla cuántos pasajes de los rollos de Herculano ha completado ya. Lo que sí consta es el corpus, 600 millones de palabras, y el equipo que lo ha construido. Dimitris Vlitas, socio de Sail Reply, resumió el salto diciendo que un procesamiento especializado así era impensable hace un año.
Para quien haya seguido el asunto de los rollos carbonizados, la noticia tiene algo de cierre de círculo. Cuando la erupción del año 79 sepultó Herculano, el Coliseo aún no se había inaugurado. Dos milenios después, un programa entrenado con la lengua de aquellos escribas propone las palabras que el fuego convirtió en huecos. No es magia: es estadística aplicada con criterio filológico.
El siguiente paso anunciado es la extensión a otras lenguas clásicas, empezando por el latín y el egipcio. Ahí el reto cambia, porque no se trata solo de vocabulario: el corpus disponible es menor y la variedad dialectal documentada, más estrecha. Armand D’Angour, profesor en Oxford, la universidad que custodia el mayor archivo de papiros antiguos, describió el valor de tener —tres posibles palabras que podrían caber en ese espacio—. Eso, dijo, aceleraría enormemente las cosas.
El chatbot se abrirá a la comunidad universitaria; no hay fecha pública de acceso general. Mientras llega, la pregunta interesante ya no es si una máquina puede leer un papiro quemado. Es cuánto de lo que lea estaremos dispuestos a dar por bueno. El proyecto puede consultarse a través de la Academia Austriaca de Ciencias, y el contexto histórico de los rollos aparece glosado en la entrada de los papiros de Herculano.
🔬 Ficha del Descubrimiento
- Qué se ha descubierto: un modelo de lenguaje entrenado con 600 millones de palabras de textos griegos antiguos que predice y completa pasajes perdidos en papiros, inscripciones y manuscritos dañados.
- Dónde: desarrollado en Viena por la Academia Austriaca de Ciencias, con aplicación directa al corpus de rollos carbonizados de Herculano (Italia).
- Institución responsable: Academia Austriaca de Ciencias, en colaboración con la empresa Sail Reply y el laboratorio Mistral.
- Cuándo: presentación pública del modelo en 2026; sus responsables no han anunciado fecha de publicación con revisión por pares.
- Impacto a futuro: acelera la lectura de colecciones de papiros en todo el mundo y abre la puerta a modelos equivalentes para el latín y el egipcio.