Las simulaciones atomísticas permiten estudiar el comportamiento de moléculas y materiales, pero los métodos de mecánica cuántica, como la teoría del funcional de la densidad, pueden resultar costosos para sistemas grandes o simulaciones prolongadas. Los potenciales interatómicos clásicos son más rápidos, aunque sus formas funcionales fijas limitan su precisión y generalización. Los potenciales interatómicos de aprendizaje automático (MLIP) buscan combinar rapidez y precisión mediante redes neuronales que predicen energías potenciales y fuerzas.
Su ejecución plantea un reto numérico: pequeños errores en las fuerzas pueden acumularse durante la dinámica molecular y afectar la estabilidad de la trayectoria. Por eso, muchos MLIP siguen usando inferencia FP32, aunque las GPU de NVIDIA ofrecen mayor rendimiento en multiplicaciones matriciales de menor precisión mediante Tensor Cores.
Métodos Tensor Core y evaluación de PET
Los métodos Tensor Core para FP32 descomponen los operandos en componentes de menor precisión, calculan productos parciales en Tensor Cores y recombinan los resultados con acumulación FP32. El artículo evalúa BF16x9 en GPU NVIDIA Blackwell y TF32x3 en GPU NVIDIA Ampere sobre Point Edge Transformer (PET), un MLIP basado en transformadores desarrollado por Lab COSMO en EPFL. La evaluación compara el rendimiento de kernels y de simulaciones de dinámica molecular, además de la precisión y el comportamiento de las trayectorias.
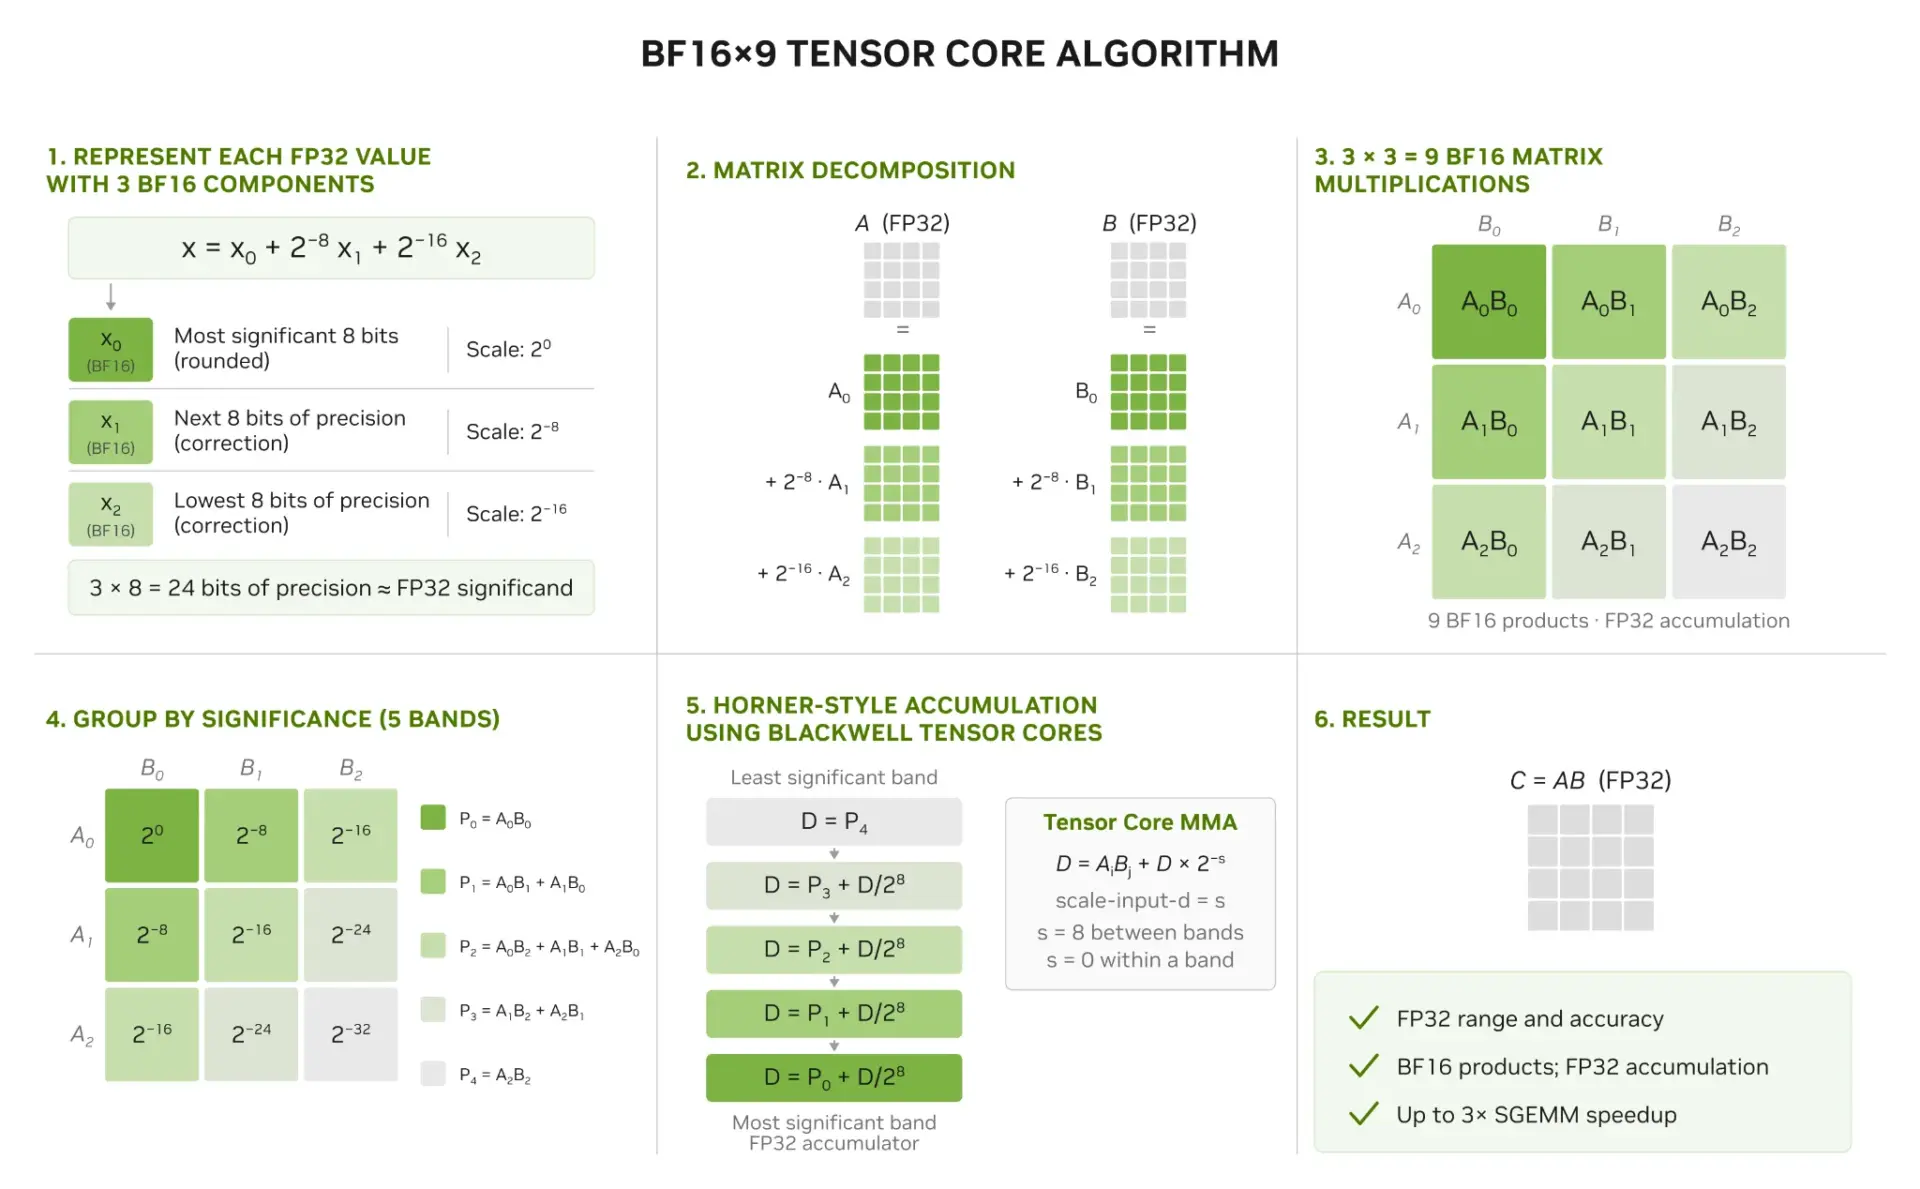
En Blackwell, BF16x9 divide cada operando FP32 en tres componentes BF16 y combina nueve productos parciales. cuBLAS permite habilitarlo, entre otras opciones, con la variable de entorno CUBLAS_EMULATE_SINGLE_PRECISION=1, sin modificar la arquitectura del modelo. En Ampere, TF32x3 representa cada operando mediante un componente TF32 principal y otro residual; calcula tres productos y omite el producto residual por residual. CUTLASS ofrece este método mediante el operador OpMultiplyAddFastF32.
La evaluación utilizó el modelo PET-MAD pequeño, de 26 millones de parámetros, con sistemas de agua de 192 y 17.280 átomos, y el modelo grande, de 255 millones de parámetros, con el sistema de 192 átomos. Se compararon energías, fuerzas y tensiones con la ruta FP32 nativa.
Rendimiento de BF16x9 y TF32x3
En Blackwell, las multiplicaciones matriciales grandes de PET fueron entre 2,2 y 2,5 veces más rápidas con BF16x9 en el sistema de 17.280 átomos. Para los pasos de dinámica molecular, la estrategia de cuBLAS que emplea BF16x9 cuando prevé que será más rápido obtuvo una aceleración de 1,2 veces en el sistema de 192 átomos y de 1,7 veces en el de 17.280 átomos. La estrategia que lo usa siempre que la operación lo admite alcanzó, respectivamente, 1,1 y 1,4 veces. El error del método BF16x9 quedó por debajo del nivel de no determinismo propio del modelo.
En una GPU A100, TF32x3 aceleró entre 1,7 y 1,9 veces las principales multiplicaciones matriciales del modelo. Para el modelo pequeño, el paso de dinámica molecular fue 1,5 veces más rápido en el sistema grande; el error de fuerza fue aproximadamente tres veces la diferencia observada entre ejecuciones FP32 tras recompilar. En el sistema de 192 átomos, el modelo grande alcanzó una aceleración de 1,4 veces, frente a 1,2 veces para el pequeño. Su error de fuerza fue de 3,9 × 10⁻⁶ eV/Å.
La comparación también incluyó TF32 de una pasada. Este método obtuvo mayores aceleraciones, pero con más coste en precisión y estabilidad de trayectoria que TF32x3. Los resultados dependen del tamaño del sistema, de la proporción de tiempo dedicada a multiplicaciones matriciales y, para TF32x3, del ajuste de los kernels a las formas de las matrices y al hardware.
Comprobaciones físicas y relajación estructural
Para estudiar la suavidad de la energía potencial, se separó rígidamente una molécula de CO de un sitio superior de una superficie Pt(111) y se evaluó la energía total en 60 alturas del carbono, entre 1,2 y 6,0 Å, con pasos de 8,1 × 10⁻² Å. TF32x3 siguió la curva suave de FP32, mientras que TF32 de una pasada mostró variaciones visibles entre puntos.
En una simulación NVE independiente de una caja de agua de 192 átomos, FP32 y TF32x3 presentaron fluctuaciones de energía acotadas y comparables; TF32 de una pasada mostró una deriva sistemática mayor. En estos sistemas probados, los resultados indican que TF32x3 mantuvo la suavidad de la energía potencial y la conservación de energía.
También se relajó una superficie de aleación Cantor de 539 átomos con PET y el optimizador FIRE2 del NVIDIA ALCHEMI Toolkit. En tres réplicas, FP32 convergió en 218 pasos y TF32x3 en entre 218 y 222; todas alcanzaron el criterio de fuerza de 1,0 × 10⁻³ eV/Å. TF32 de una pasada no convergió en ninguna de las tres réplicas dentro del límite de 500 pasos y las fuerzas se estabilizaron en torno a 1,2 × 10⁻³ eV/Å.
Resultados y alcance
TF32x3 aceleró 1,5 veces cada paso de optimización y mantuvo el ritmo y el criterio de convergencia de FP32. TF32 de una pasada fue dos veces más rápido por paso, pero no convergió incluso al duplicar el límite a 1.000 pasos. Los autores señalan que el comportamiento numérico debe validarse según los requisitos de precisión y estabilidad física del modelo; en pruebas de multiplicación matricial, BF16x9 igualó o superó la precisión de FP32 frente a una referencia FP64.
En conjunto, los métodos Tensor Core FP32 mejoraron el rendimiento de PET sin reentrenar el modelo ni cambiar su arquitectura. TF32x3 aceleró las principales multiplicaciones matriciales en A100 hasta 1,9 veces y el paso completo de dinámica molecular hasta 1,5 veces. En una GPU NVIDIA B300, BF16x9 aceleró esas multiplicaciones hasta 2,5 veces y el paso completo hasta 1,7 veces. La conservación de energía y la relajación estructural se evaluaron para TF32x3 en los sistemas descritos.
El artículo propone evaluar estos métodos en otros MLIP y modelos científicos de aprendizaje automático sensibles a la precisión cuyo tiempo de ejecución esté dominado por grandes multiplicaciones matriciales FP32. La combinación con otras optimizaciones de software podría evaluarse cuando el flujo de trabajo lo permita; la ganancia conjunta no se midió en esta evaluación. Se ofrecen documentación de cuBLAS y del NVIDIA ALCHEMI Toolkit, además de los modelos PET en el repositorio UPET.
Los autores agradecen las contribuciones de Nikita Fedik, Harun Bayraktar, Gregory Thomsen y Vamsi Sripathi.