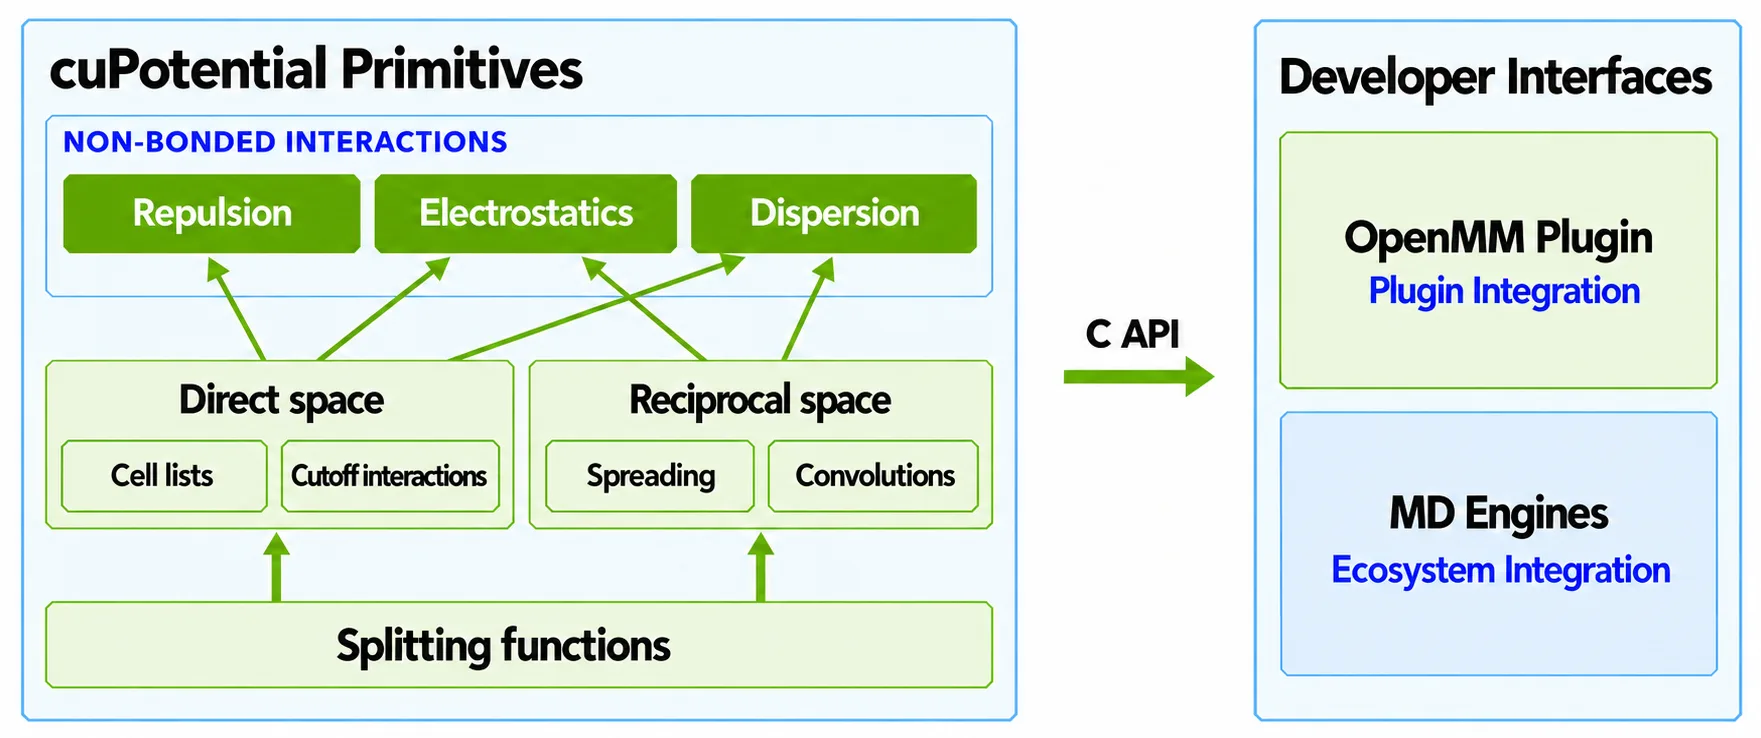
cuPotential, una biblioteca de NVIDIA para acelerar simulaciones de dinámica molecular, ofrece componentes modulares que pueden integrarse en distintos motores mediante una API de C. La compañía presenta un complemento para OpenMM, con el objetivo de sustituir algunas funciones del programa con cambios mínimos en el código.
La biblioteca aborda, entre otros aspectos, el cálculo de interacciones de largo alcance bajo condiciones periódicas, que constituye un cuello de botella computacional y de desarrollo en simulaciones con campos de fuerza clásicos. El complemento para OpenMM incluye reemplazos para la fuerza no enlazada, el integrador Langevin y el barostato Monte Carlo.
Integración y requisitos
La guía de NVIDIA explica cómo compilar e instalar el complemento en Linux con Conda o Micromamba. Para ello se necesita un equipo x86-64, una GPU NVIDIA compatible, un controlador compatible con CUDA 13.1 y una copia del repositorio de cuPotential en GitHub. El entorno incorpora las herramientas de desarrollo de CUDA; el controlador debe estar instalado en el equipo.
La instalación incluye la compilación de la biblioteca y el complemento, la instalación del paquete de Python y la ejecución de muestras con los sistemas DHFR, BACE y ApoA1, bajo condiciones NVT y NPT. Las pruebas comparan la precisión con referencias de doble precisión y miden el rendimiento tras 500 pasos de calentamiento y 3.000 pasos cronometrados.
Uso y resultados de rendimiento
Para integrar cuPotential, la guía indica que hay que sustituir la fuerza no enlazada de OpenMM antes de crear el contexto de simulación y utilizar el integrador de la biblioteca; el barostato es opcional. El complemento está orientado a sistemas solvatados, de densidad aproximadamente uniforme y cajas periódicas rectangulares. No admite LJPME, cajas triclínicas ni desplazamientos de parámetros de partículas o excepciones de OpenMM.
Según los resultados presentados por NVIDIA, las pruebas abarcan sistemas de entre 24.000 y 400.000 átomos y varias GPU. En algunos ensayos, las RTX PRO 6000 Blackwell superan una aceleración de tres veces; otras GPU probadas registran mejoras que, a menudo, rondan el doble o más. La compañía precisa que las cifras corresponden a sistemas estándar no alquílicos.

Precisión de los métodos
NVIDIA también describe nuevos métodos de separación y distribución de interacciones, desarrollados en colaboración con D. E. Shaw Research y el Flatiron Institute. En las pruebas de electrostática, la compañía señala que estos métodos permiten reducir el corte en el espacio real o el tamaño de la cuadrícula recíproca sin pérdida de precisión respecto al régimen de referencia usado en el análisis.
Para las interacciones de dispersión, NVIDIA informa de una mejora de varios miles de veces en la precisión de la energía frente a métodos convencionales, con errores de fuerza comparables y menor coste computacional. La comparación se realizó con sistemas y parámetros concretos; el texto también advierte de dificultades al reducir el corte a 6 Å por la complejidad de NBFix y las reglas de combinación.


Deriva de energía y acceso al código
En un ensayo de 10 nanosegundos con un sistema de agua rígida, NVIDIA comparó cuPotential y OpenMM estándar con un corte de 9 Å y una referencia PME convergida con un corte de 20 Å. La compañía afirma que cuPotential redujo la deriva de energía varios cientos de veces frente a la configuración predeterminada de PME. El análisis utilizó pasos de 2 femtosegundos y una temperatura de 300 K.
El código, ejemplos y pruebas están disponibles en el repositorio de NVIDIA cuPotential. NVIDIA agradece las contribuciones científicas y matemáticas de D. E. Shaw Research y del Centro de Matemáticas Computacionales del Flatiron Institute.